반론과 한계
실패, 비용 급증, 경쟁 모델이 나았던 경우입니다.
8가지반론과 한계
실패, 비용 급증, 경쟁 모델이 나았던 경우입니다.
8가지실패, 비용 급증, 경쟁 모델이 나았던 경우입니다.
잘 안 된 경우와 비용이 크게 든 경우도 함께 모았습니다.
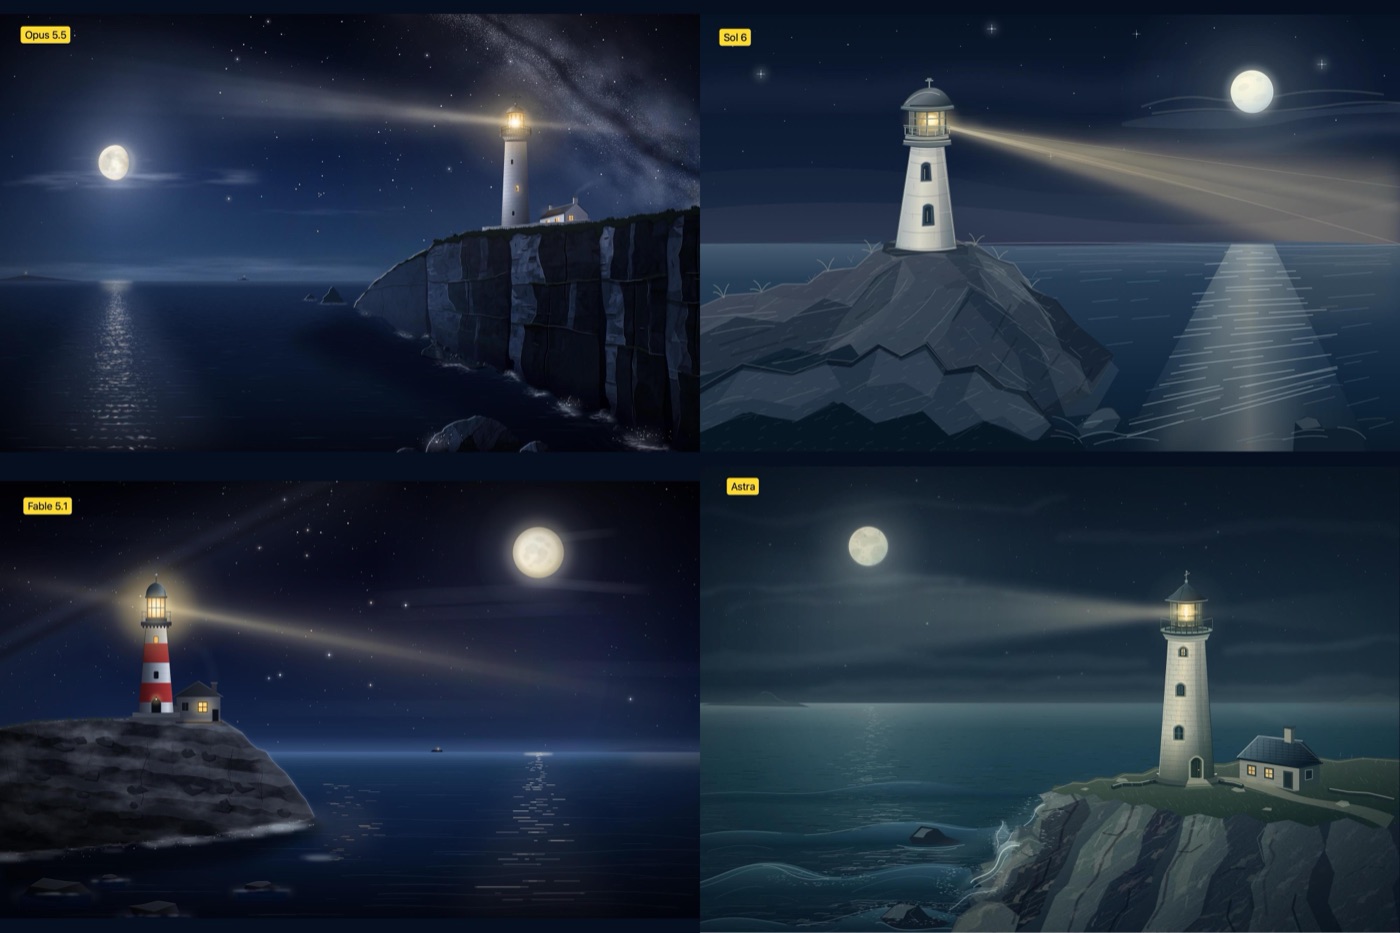
Simon Willison의 펠리컨 그림 시험에서 max 강도는 출력 한도 12만 8천 토큰을 생각하는 데 다 쓰고 답을 내지 못했습니다(두 번, 회당 약 2.56달러·20분). 같은 조건의 Fable 5.1은 성공했습니다. playcode.io에서도 같은 일이 일어났고, 한 단계 낮은 xhigh는 1.72달러로 Fable 5.1과 비슷한 품질을 냈습니다.
Artificial Analysis가 잰 작업당 비용은 low 0.55달러, medium 1.34달러, high 1.82달러, xhigh 3.46달러, max 5.98달러입니다. max는 Opus 5 max(5.86달러)와 비슷합니다. '40% 저렴'은 기본 설정에서의 이야기입니다.
3D 장면 4개를 만들게 하자 Opus 5.5는 4.37달러, GPT-6 Sol은 0.34달러가 들었습니다. 결과물은 Opus 쪽이 더 촘촘했지만, 정답 하나당 실제 비용으로 따지면 Sol이 3.4배 쌉니다.
250점 만점에 Sol 237점, Opus 5.5 221점입니다. 디자인은 Opus가 5판 중 4판을 이겼지만 속도는 Sol이 모두 이겼습니다(43분 대 77분). Opus가 테스트를 정리하다 컴퓨터의 파이썬 프로세스를 모두 꺼 버려 녹화가 끊기기도 했습니다.
같은 그림 과제에서 Opus 5.5는 사용량이 2,000 AIU를 넘어 중간에 멈춰야 했습니다. Fable 5.1은 811, Sol은 126이었습니다(Astra의 378 AIU가 3.78달러). medium 강도로 돌리면 약 180 AIU였습니다.
한 번에 만든 게임 게시물에서 가장 많은 공감을 받은 댓글은 '실제로 해 보면 버그투성이', '이건 한 번에 만든 게 아니다'였습니다. 작은 행성 게시물에도 '차량이 궤도를 벗어나는 버그'라는 지적이 달렸습니다.
디자인 이미지를 HTML로 옮기는 비교에서 페이지 전환 애니메이션 지시를 빠뜨렸고, 네 모델 가운데 로딩이 가장 느렸습니다.
'Opus 5도 출시 때 Fable 5급이라더니 실제로는 대화도 잘 안 됐다'는 댓글이 202표를 받았습니다.