숫자로 확인된 성과
외부 평가와 공식 발표의 숫자입니다.
24건숫자로 확인된 성과
외부 평가와 공식 발표의 숫자입니다.
24건외부 평가와 공식 발표의 숫자입니다.
외부 기관이 잰 결과와 회사가 스스로 잰 결과를 나눠 담았습니다. 같은 시험도 재는 곳마다 숫자가 조금씩 다릅니다. 예를 들어 Terminal-Bench 4.0은 Anthropic 66.4%, Artificial Analysis 59.6%, Vals AI 61.62%입니다.
| 평가 | 결과 | 비교와 조건 | 출처 |
|---|---|---|---|
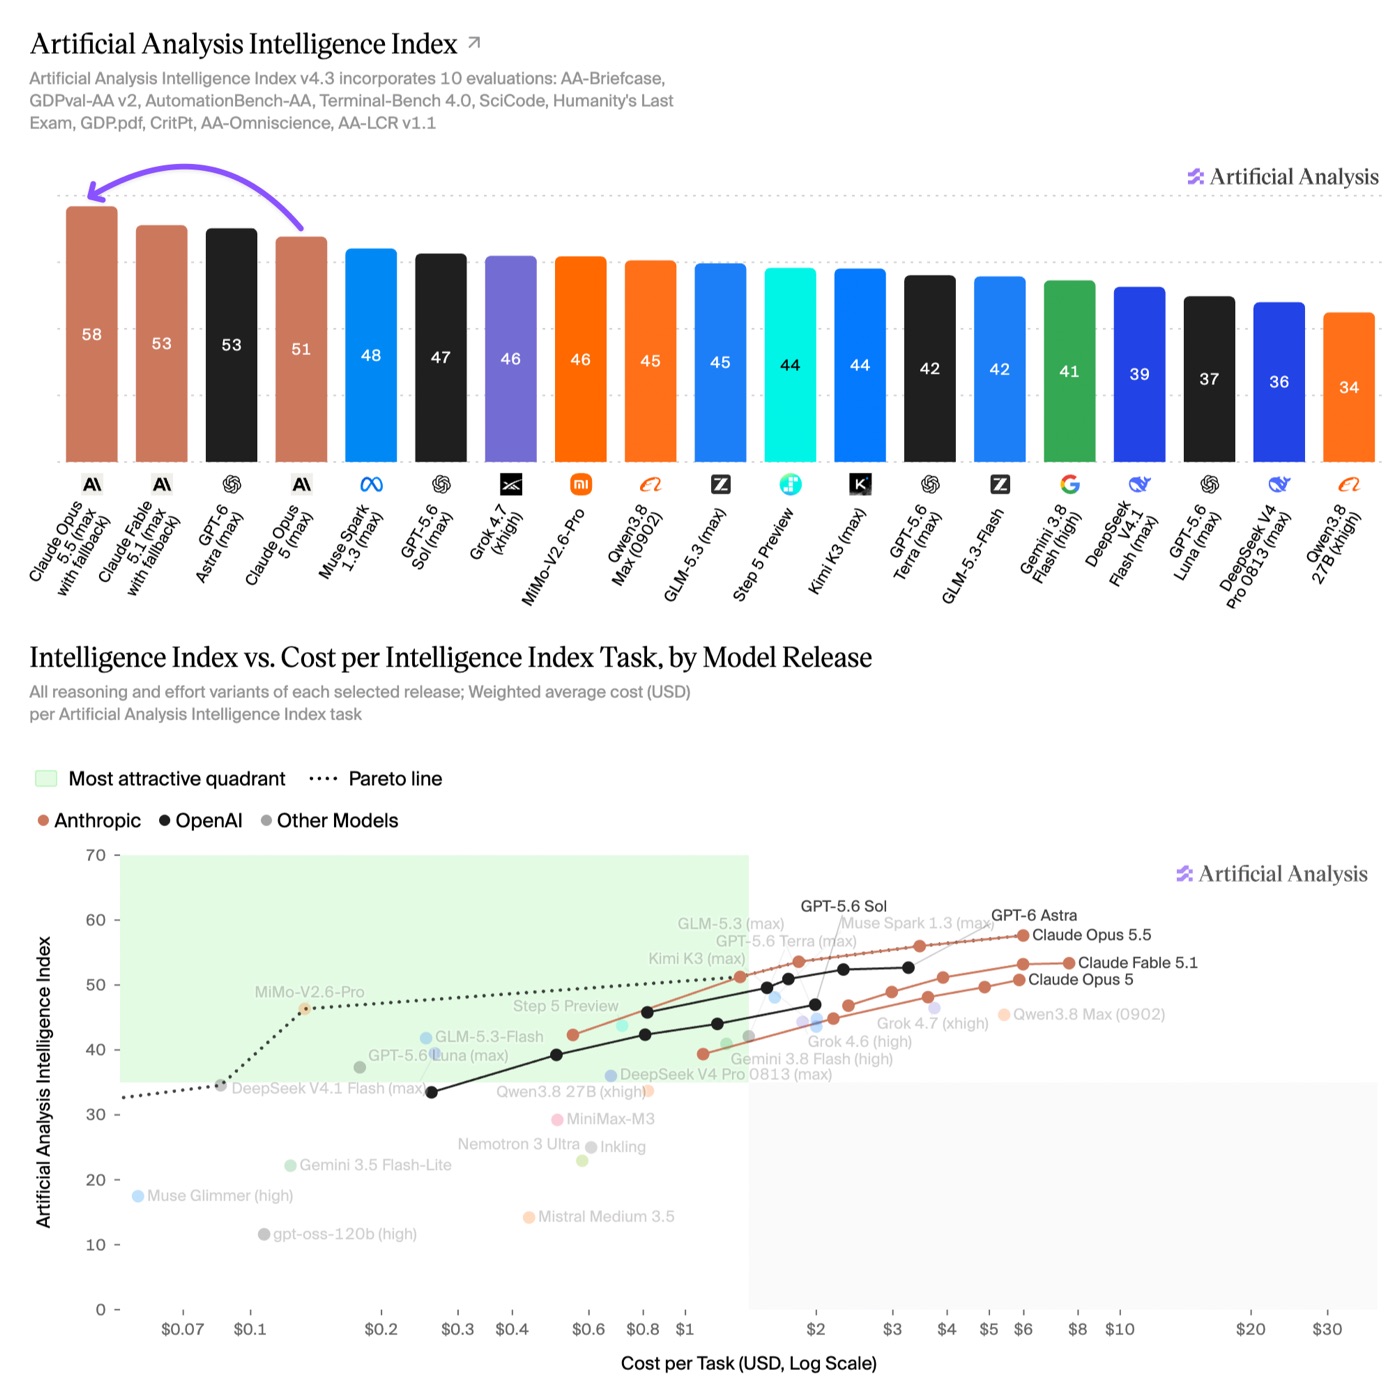
| Artificial Analysis 지능 지표 | 58점, 1위 | GPT-6 Astra·Fable 5.1 53점, Opus 5 51점. max 강도 기준. 작업당 비용은 max 5.98달러로 Opus 5 max(5.86달러)와 비슷 | AA 분석 |
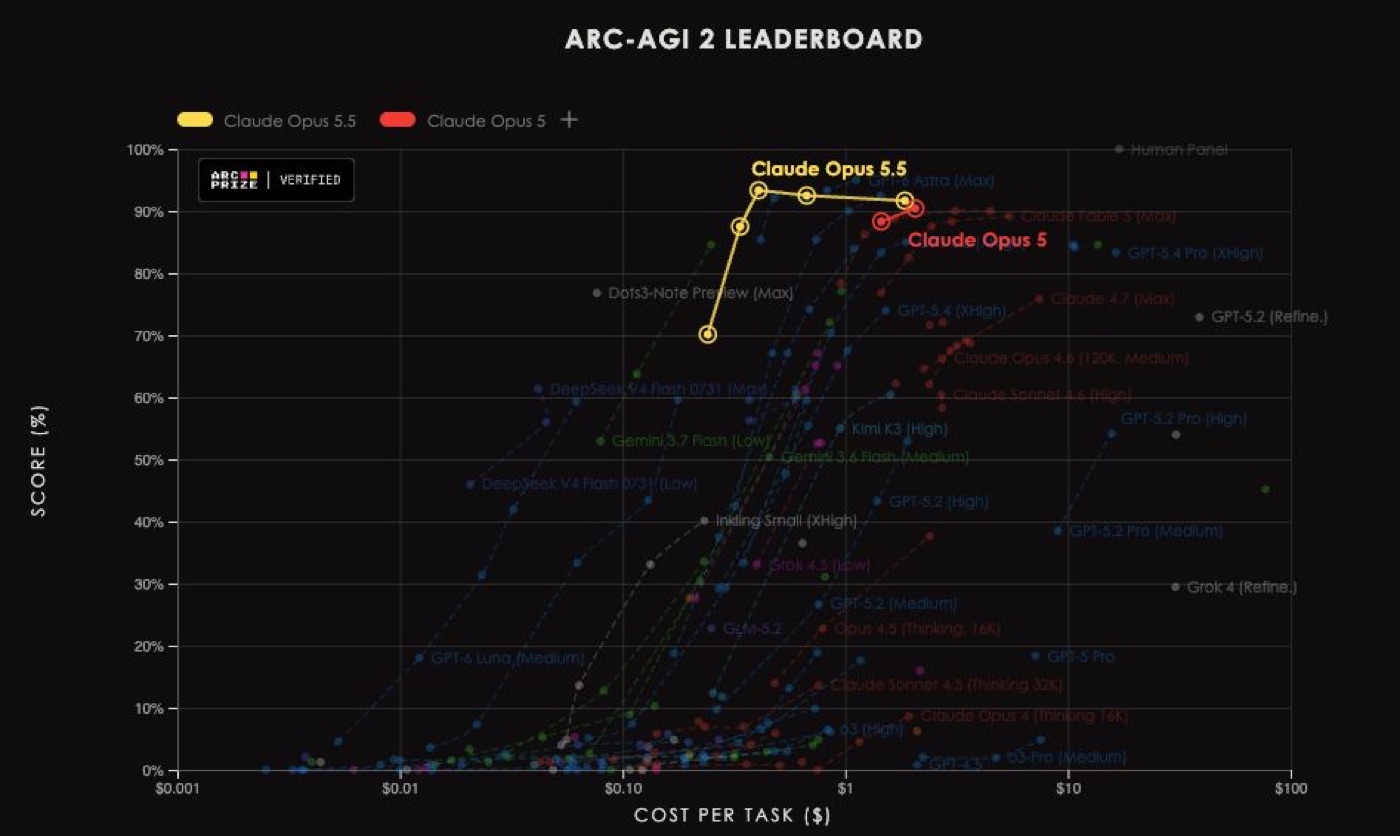
| ARC-AGI-2 (ARC Prize 검증) | 93.3%, 문제당 0.41달러 | Opus 5보다 2.9%p 높고 채점 비용은 약 80% 낮음. ARC-AGI-1은 98.5%, 문제당 0.16달러 | @arcprize |
| Vals AI | 6개 평가에서 1위 | Terminal-Bench 2.1 87.64%, Terminal-Bench 4.0 61.62%, ProofBench v1.1 100%, MedScribe 91.43% 등 | vals.ai |
| METR | AI 연구개발 속도 약 1.5배 | 외부 안전성 평가 기관의 추정. "Fable 5.1 대비 소폭 개선"이라고 평가 | METR 블로그 |
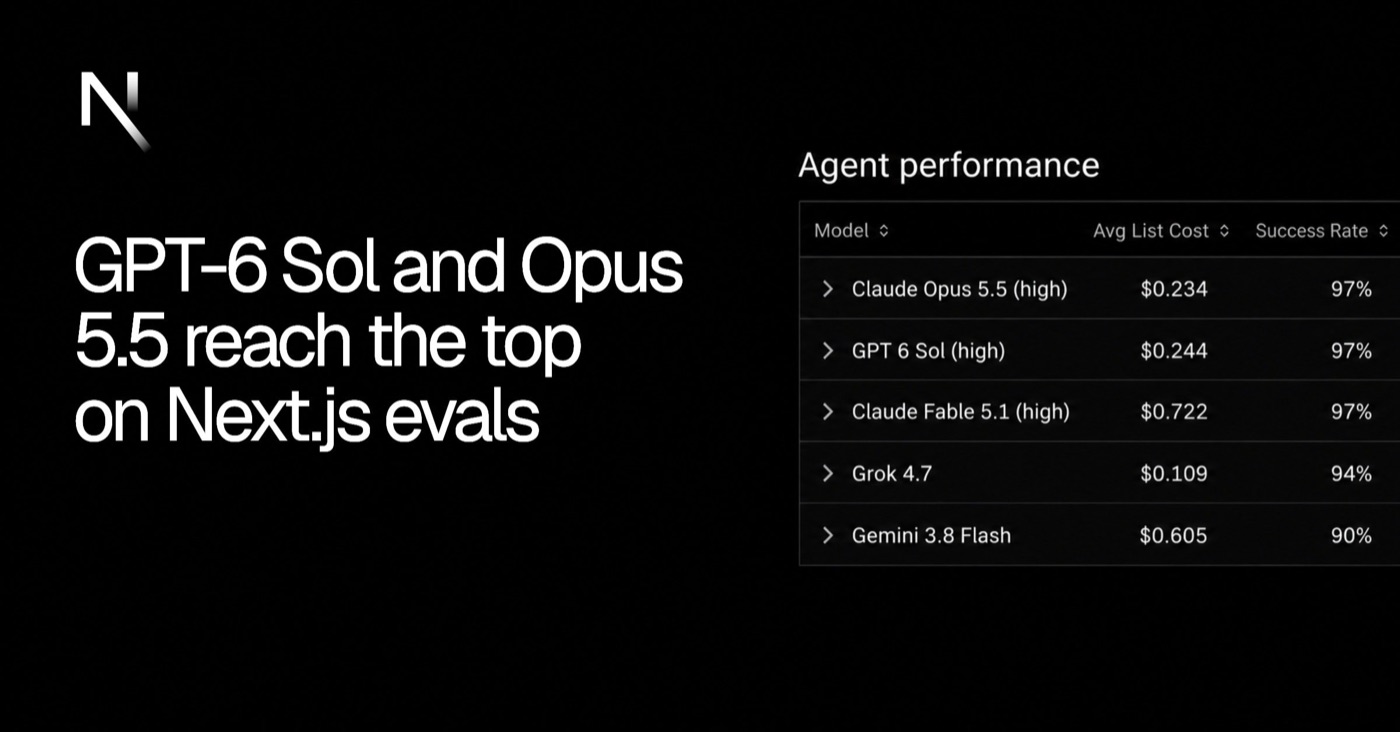
| Next.js 평가 (Vercel) | 성공률 97%, 공동 1위 | GPT-6 Sol·Fable 5.1도 97%. 평균 비용은 Opus 5.5가 0.234달러로 셋 중 가장 낮음 | @nextjs |
| 시험 | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 (터미널 작업) | 66.4% | 52.3% | 55.8% |
| SWE-bench Pro (실제 코드 수정, 시스템 카드) | 89.9% | 79.2% | 81.2% |
| OSWorld 2.0 (컴퓨터 조작) | 81.8% | 74.0% | 80.7% |
| GDPval-AA (지식 노동) | 1,846점 | 1,708점 | 1,735점 |
230쪽짜리 시스템 카드에는 에이전트 100개 이상이 24시간 동안 함께 일하는 장기 과제에서, 팀 크기와 관계없이 Opus 5와 Fable 5.1을 앞섰다는 결과도 있습니다(193~194쪽).
| 회사 | 결과 | 출처 |
|---|---|---|
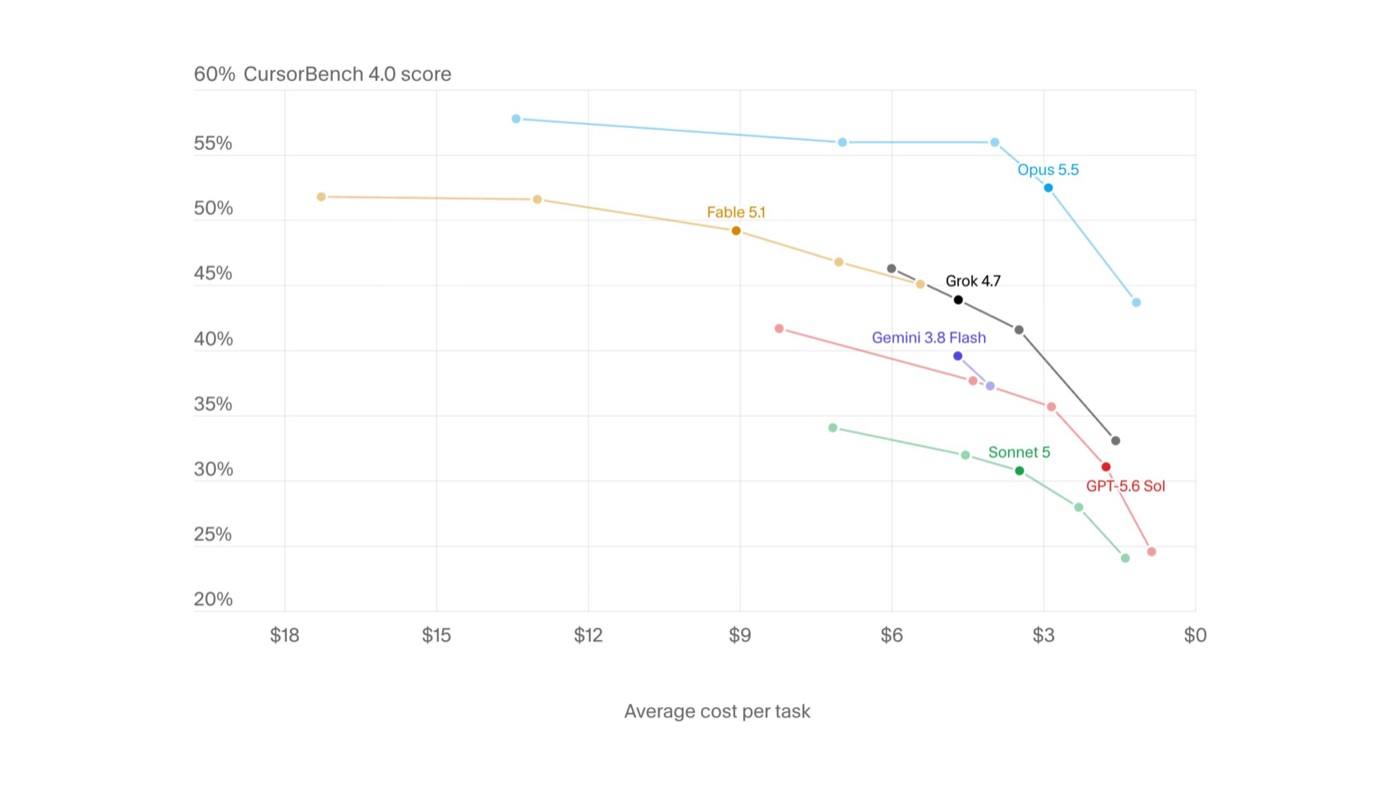
| Cursor | 자사 코딩 시험 CursorBench 57.8%(Max)로 출시 시점 최고, 작업당 비용 40% 절감 | @cursor_ai |
| Cognition (Devin) | FrontierCode 1.1 1위, Extended 65.3%. Fable 5 비용의 10분의 1 미만 | Devin 블로그 |
| Perplexity | 자체 평가 WANDR 0.610, 작업당 4.13달러. Fable 5.1보다 조금 높고 67.6% 저렴 | @perplexity_ai |
| GitHub Copilot | Opus 5와 비슷한 해결률을 훨씬 적은 단계와 토큰으로. GitHub CPO는 "절반 이하 단계로 더 많이 해결" | GitHub 변경 기록 |
| Lovable | 기존 코드에서 최대 48% 적은 단계, 품질은 그대로 | @Lovable |
| CodeRabbit | 알려진 버그 80개 중 51개(기존 49개), 어려운 13개 중 10개(기존 5개). 대신 토큰 약 50% 더 쓰고 기존이 잡던 9개는 놓침 | @coderabbitai |
| depthfirst | 보안 시험 dfbench에서 high 강도로 재현율 54.9%, 정밀도 48.5%. 작업당 8.42달러 | X 원문 |
| Deloitte | 가장 낮은 강도로도 알려진 버그 72% 검출(Opus 5는 high로 56%) | Anthropic 발표 인용 |
| Hebbia | 금융 업무 전체 흐름 충족률 86.6%(Opus 5는 60.3%) | Anthropic 발표 인용 |
| Quantium | 38번의 요청과 4일 걸리던 코딩 작업이 11번의 요청과 3시간으로 | Anthropic 발표 인용 |
| Stripe | 서로 이어진 PR 40개를 최신 코드 위로 다시 올리는 며칠짜리 작업에서 충돌 지점을 명확히 정리했고, 다음 날 오후 40개 모두 자동 테스트 통과 | Anthropic 발표 인용 |
| Optiver | 절반의 대화 횟수·시간·출력으로 같은 품질, 해당 작업 비용 40~50% 절감 | Anthropic 발표 인용 |
| Box | 토큰은 3분의 1, 답변은 40% 덜 장황, 정확도는 그대로 | Anthropic 발표 인용 |
| Walleye Capital | 자사 지시문에서 분 단위 번호가 하나씩 밀려 있는 것을 스스로 찾아 바로잡았고, 그 때문에 채점 점수가 깎일 수 있다고 먼저 알림 | Anthropic 발표 인용 |
| 익명 초기 테스터 | 68만 줄 코드 이전을 하루 안에. 엔지니어 팀이면 몇 주 걸릴 일 | Anthropic 발표 |